Cet article explique comment générer des images avec Stable Diffusion 3.5 (SD 3.5) en utilisant Python, en insistant sur les aspects pratiques pour des configurations avec peu de VRAM, comme un ordinateur portable équipé de 6 Go de VRAM.
Cadre et prérequis
Nous supposons que vous possédez un compte Hugging Face et que vous pouvez vous connecter en ligne de commande. Dans cet article nous utiliserons les modèles Stable Diffusion 3.5 large et Stable Diffusion 3.5 medium de Stability AI, disponibles sur Hugging Face. Créez l’environnement Python et installez les dépendances nécessaires, en privilégiant les versions 3.10 ou 3.11 selon votre distribution.
Comprendre l’environnement Python et les ressources matérielles est crucial, car la génération d’images nécessite une grande quantité de RAM GPU. Le script Python affiche des informations sur les versions installées et le matériel disponible, et il est basé sur une réponse StackOverflow citée dans le document d’origine.
Préparer l’environnement et installer les dépendances
Pour commencer la génération avec Stable Diffusion 3.5, vous devez disposer de CUDA et des bibliothèques associées. Vérifiez votre version de CUDA et assurez-vous d’installer pytorch, torchvision et torchaudio dans votre environnement virtuel, puis importez la pipeline StableDiffusion depuis diffusers. Cette étape pose les bases de l’utilisation des transformers sur votre machine locale.
Selon la configuration, l’installation peut nécessiter git LFS et le téléchargement des weights du modèle. Dans les configurations standard, l’installation et la préparation prennent du temps, notamment lorsque vous utilisez des connexions réseau plus lentes.
Lancer le pipeline Stable Diffusion 3.5
Maintenant que CUDA est opérationnel, vous pouvez commencer à générer des images. Les modèles SD 3.5 demandent une grande quantité de VRAM et le chargement en VRAM peut être lent, mais les variantes plus petites permettent d’alléger cette charge.
Texte descriptif : l’exemple original de Hugging Face peut exiger une carte graphique avec plus de 24 Go de VRAM. Si votre GPU n’atteint pas ce seuil, vous pouvez passer à une variante plus légère, par exemple le modèle moyen « stabilityai/stable-diffusion-3.5-medium » pour réduire les besoins en VRAM et accélérer les itérations.
Pour les configurations avec très peu de VRAM, une étape clé consiste à quantifier le modèle afin de réduire la précision et ainsi consommer moins de mémoire pendant l’inférence. Quantize Stable Diffusion 3.5 avec Quanto permet d’obtenir une VRAM encore plus faible, en visant qint4 comme quantification minimale utile. Cette approche permet d’utiliser près de 5.9 Go de VRAM lors de l’inférence sur certaines configurations, tandis que le modèle moyen peut descendre à environ 2.8 Go et environ 5 secondes par itération.
Utilisation d’un seul GPU et multi-GPU
Si vous avez plusieurs GPUs ou un GPU externe via Thunderbolt, vous pourriez avoir à sélectionner l’unité GPU correcte avant d’exécuter le pipeline. Le script d’informations sur Python peut aider à déterminer l’indice du GPU externe et ainsi éviter les conflits de ressources.
En cas de GPU externe via Thunderbolt, vous pouvez rencontrer des comportements où le GPU externe disparaît après quelques secondes ou minutes de fonctionnement. Le problème peut venir du PCIe power management et peut être contourné en ajustant les paramètres du noyau, par exemple en désactivant pcie_aspm. Notez que cela peut influencer la consommation d’énergie et la stabilité générale du système.
Variantes et performances
Pour les ordinateurs portables avec 6 Go de VRAM, l’approche recommandée est de passer à la version moyenne du modèle et, si nécessaire, d’appliquer une quantification plus agressive (qint4) pour réduire encore l’empreinte mémoire. Le calcul et l’inférence restent relativement rapides avec ces variantes, même si la précision et la fidélité peuvent être légèrement diminuées par rapport au modèle complet.
Tableau récapitulatif (basé sur les indications du matériel et des variantes) :
| Modèle | VRAM estimée en inference | Temps par itération | Qualité / fidélité |
|---|---|---|---|
| SD 3.5 large | ≥ 24 Go | ≈ 20 s | Haute fidélité |
| SD 3.5 medium | ≈ 2.8-5 Go | ≈ 5 s | Médiocre à neutre |
| SD 3.5 quantifié (qint4) | ≈ 5.9 Go | ≈ 21 s | Stabilité et mémoire optimisées |
Bonnes pratiques et dépannage
Les messages d’erreur et les messages de configuration les plus fréquents tournent autour de la disponibilité de la VRAM et de la compatibilité des dépendances. Assurez-vous que votre environnement virtuel est correctement configuré et que les versions de diffusers et des dépendances CUDA sont à jour (par exemple, pip install -U diffusers).
En cas de défaillance liée à l’alimentation ou au comportement des GPU externes, vérifiez les paramètres du kernel et envisagez une réinstallation/lprediction des pilotes, le redémarrage du système pouvant être nécessaire après des ajustements systèmes.
Ressources et contexte
Stable Diffusion 3 est une évolution des modèles Open Source pour la génération d’images à partir de descriptions textuelles, avec une licence communautaire et des considérations de sécurité et de qualité des contenus. Le texte peut mentionner des aspects tels que le cadre de Safety by Design et les filtres mis en place, ainsi que les mécanismes de vérification et les limitations de la modélisation.
Notez que Stability AI inclut des informations sur les exigences de licence et les usages autorisés du modèle, et que l’utilisation commerciale peut nécessiter une licence adaptée si les revenus dépassent un seuil donné.
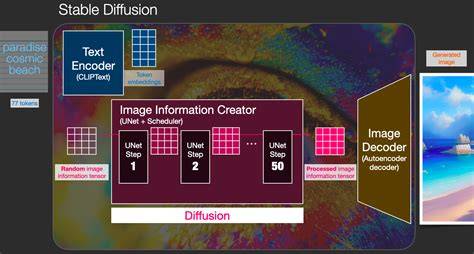
Exemple pratique d’intégration
Le pipeline Stable Diffusion via diffusers peut être utilisé ainsi, avec les bons paramètres et les ajustements de VRAM. En adaptant les prompts et les paramètres, vous pouvez obtenir des images de haute qualité tout en restant dans les limites de votre matériel.
Installer et utiliser Stable Diffusion (en local via AUTOMATIC1111)
Idées de visualisations et informations utiles
Pour améliorer l’informativité de l’article, des infographies peuvent illustrer: les variantes SD 3.5 et leurs exigences VRAM, le workflow de quantification avec Quanto et les conseils de dépannage pour les GPU externes Thunderbolt.
Plus loin, des éléments tels que les blocs de texte et les encodages peuvent être clarifiés par des schémas simples montrant le travail des text encoders et l’impact de la quantification sur l’inférence.