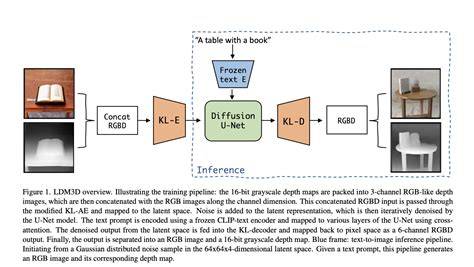
Stable Diffusion transforme des prompts textuels en images via un processus de diffusion latente. Le modèle de base génère une image à partir de bruit, guidé par un encodeur de texte qui interprète la description. L'utilisateur contrôle le résultat via le prompt, les prompts négatifs, le nombre d'étapes de débruitage, le CFG (classifier-free guidance) et le seed. Les cas d'usage professionnels couvrent le concept art, la génération de textures pour le jeu vidéo, la prévisualisation architecturale, la création de visuels marketing personnalisés et la production de datasets synthétiques pour l'entraînement d'autres modèles.
Les tutos couvrent Stable Diffusion de l'installation locale jusqu'aux workflows de production avancés. Pour les créatifs qui souhaitent explorer d'autres approches de la génération d'images IA, Tuto.com propose des cours sur Midjourney pour la qualité esthétique sans installation, Adobe Firefly pour l'intégration dans Photoshop, ou encore DALL·E intégré à ChatGPT. Stable Diffusion 3, annoncé en février 2024, a introduit l'architecture MMDiT (Multimodal Diffusion Transformer) qui améliore la gestion du texte dans les images et la compréhension des prompts complexes. SD 3.5, sorti fin 2024, en est la version optimisée pour un meilleur équilibre entre qualité et performances. L'écosystème communautaire continue de croître en 2026. ComfyUI s'est imposé comme l'interface de référence dans les studios VFX et de jeu vidéo grâce à son système de nodes qui permet de chaîner les modèles et les étapes de traitement dans des pipelines reproductibles. Civitai héberge des milliers de modèles fine-tunés (Juggernaut XL, Realistic Vision, DreamShaper) et de LoRA spécialisés. Stable Diffusion a été publié en open source en août 2022 par Stability AI, en collaboration avec le CompVis Lab de l'université de Munich et Runway. La version 1.5 reste l'un des modèles les plus fine-tunés de l'histoire de l'IA, avec des milliers de dérivés encore utilisés en 2026. SDXL (juillet 2023) a porté la résolution native à 1024x1024 avec un pipeline à deux étages (base + refine). SD 3 (2024) a marqué le passage à l'architecture Transformer.
Vous pouvez avoir accès à Stable Diffusion soit directement sur votre ordinateur, soit via une interface web. Accès en local : Si vous préférez travailler en local, il est possible d’installer gratuitement Stable Diffusion sur son poste. Toutefois, la configuration est complexe et nécessite des compétences techniques avancées, ainsi que le suivi d’étapes spécifiques. Assurez-vous également que votre PC ait les capacités techniques requises, notamment une carte graphique robuste, car le traitement d’images par IA est gourmand en ressources. Cela inclut aussi l’installation de logiciels comme Python, par exemple. Néanmoins, une fois le modèle correctement installé dans votre système, vous pouvez l’exploiter selon vos besoins, aussi souvent que vous le souhaitez. Accès en ligne : Il existe une alternative plus pratique pour utiliser Stable Diffusion. Celle-ci ne demande aucune installation, juste une connexion internet : l’accès via des sites web. Plusieurs plateformes en ligne intègrent cette technologie. Il suffit dès lors d’entrer votre requête, et le système s’occupe ensuite de générer l’image.
Comment utiliser Stable Diffusion ? Accessibilité et disponibilité Stable Diffusion peut être installé localement sur PC, avec l’aide de Python et Git. Cette installation nécessite néanmoins des compétences approfondies en informatique ainsi que la capacité à maîtriser une invite de commandes. Lorsque l’on n’est pas un expert informatique, il est possible d’utiliser cette intelligence artificielle, en ligne. Comme c’est un projet open-source, son code source est librement accessible, ce qui a permis à de nombreux sites web de l’intégrer pour la création d’images. Parmi ces plateformes, on peut citer Stable Diffusion Online ou DreamStudio. À noter toutefois que la majorité d’entre elles n'ont pas de version française, les prompts doivent donc être rédigés en anglais. Stable Diffusion fonctionne grâce à des LLM qui ont été entraînés sur des millions d’images et de textes. Plus votre description est précise, plus l'image sera réaliste. Stable Diffusion propose également des fonctionnalités avancées pour affiner vos créations. Vous pouvez utiliser des LoRA pour influencer le style de l'image, comme le rendu des couleurs ou la texture. Stable Diffusion est un outil accessible à tous, que vous soyez un artiste confirmé ou un novice en matière d’IA. Stable Diffusion est un outil puissant qui ouvre de nouvelles possibilités créatives.
Si vous êtes curieux de découvrir l’IA et ses applications artistiques, Stable Diffusion est un excellent point de départ. L’intelligence artificielle transforme de nombreux domaines, et la création d’images ne fait pas exception. Depuis quelques années, des modèles comme DALL-E, Midjourney et Stable Diffusion ont révolutionné la façon dont nous concevons des visuels. Ces modèles permettent de générer des images ultra-réalistes à partir de simples descriptions textuelles, ouvrant ainsi un champ des possibles infini pour les artistes, les designers, les professionnels du marketing et bien d’autres métiers. Cependant, les solutions propriétaires comme Midjourney ou DALL-E ont leurs limites : elles sont souvent coûteuses, peu transparentes et ne permettent pas de modifier le modèle sous-jacent. Les modèles open source sont une alternative puissante et flexible aux solutions propriétaires. Voici pourquoi ils attirent de plus en plus d’utilisateurs.
- Transparence et contrôle total: Contrairement aux modèles propriétaires dont l’architecture est cachée, les modèles open source offrent un accès complet au code source et aux poids du modèle. Cela permet : De comprendre comment fonctionne l’algorithme. D’ajuster les paramètres pour obtenir de meilleurs résultats. D’adapter le modèle à des besoins spécifiques, par exemple en l’entraînant sur un dataset personnalisé.
- Réduction des coûts: Les plateformes comme Midjourney ou DALL-E nécessitent un abonnement mensuel, ce qui peut rapidement devenir coûteux. En utilisant un modèle open source : Vous ne payez que l’infrastructure (GPU, cloud computing). Vous pouvez héberger le modèle en local, évitant ainsi des frais récurrents.
- Flexibilité d’utilisation: Un modèle open source peut être utilisé de plusieurs manières : En local, si vous avez un ordinateur avec un GPU puissant. Sur le cloud, via des plateformes comme Google Colab ou Hugging Face Spaces. Intégré dans des applications et workflows personnalisés.
- Contribution et innovation communautaire: L’un des grands avantages de l’open source est la force de la communauté.
Tour d’horizon des meilleurs modèles open source disponibles et des modes d’utilisation. Stable Diffusion est sans doute le modèle open source le plus connu et le plus utilisé. Développé par Stability AI, il a été conçu pour être léger et accessible. Caractéristiques principales: Génère des images en haute résolution à partir de descriptions textuelles. Disponible en plusieurs versions: Stable Diffusion 1.5, 2.1 et SDXL. Fonctionne sur du matériel accessible, avec un GPU d’au moins 6 Go de VRAM. Avantages: Très grande communauté et nombreux tutoriels disponibles. Compatible avec des interfaces comme AUTOMATIC1111 et ComfyUI. Personnalisable grâce aux LoRAs et fine-tunings. Limitations: Moins précis dans la gestion des visages et des mains par rapport à Midjourney. Peut nécessiter des ajustements techniques pour obtenir des résultats optimaux.
DeepFloyd IF, Kandinsky 2.1 et d’autres modèles open source offrent des alternatives selon les besoins: DeepFloyd IF pour une qualité d’image exceptionnelle et une meilleure fidélité au texte, Kandinsky 2.1 pour le domaine artistique. L’installation et l’utilisation dépendent du niveau technique et des ressources disponibles. Deux modes d’utilisation principaux existent: en ligne via plateformes qui ne nécessitent pas d’installation et en local sur son ordinateur qui offre plus de contrôle et de personnalisation. Des templates et des outils comme ComfyUI facilitent les workflows en nœuds et les pipelines reproductibles. L’écosystème voit aussi des évolutions autour des capacités de texte dans les images, des optimisations de performances et des approches multimodales croissantes.
Exemple d’installation locale de Stable Diffusion et panorama des évolutions. L’installation dépend des ressources et du niveau d’expertise: pré-requis techniques (GPU recommandé, CPU puissant, RAM suffisante, espace disque) et logiciels (Python, Git, CUDA/cuDNN, environnement virtuel). Le flux de travail typique comprend l’encodage du prompt via CLIP, le débruitage en plusieurs étapes et le décodage par VAE. Des options comme le guidage sans classificateur, le réglage des étapes, de la seed et de l’échelle de guidage permettent d’obtenir des résultats précis et fidèles. Des contrôles de sécurité et des filtres existent, mais les communautés les adaptent souvent. Des interfaces comme ComfyUI et Automatic1111 offrent des expériences progressives et des extensions pour enrichir les capacités de Stable Diffusion.
Perspectives futures et enjeux. Des progrès rapides promettent des modèles plus puissants et plus rapides, une meilleure gestion du texte dans les images, et une accessibilité accrue par le cloud et des interfaces simplifiées. L’intégration multimodale et la génération de contenus images-vidéos-sons suggèrent des trajectoires vers des IA génératives plus complètes. Des questions éthiques et légales autour des droits d’auteur et de l’utilisation des datasets restent au cœur des débats. L’open source peut servir de socle pour une IA plus ouverte, collaborative et responsable, tout en stimulant l’innovation et la créativité. Stable Diffusion 3 et SD 3.5, SDXL, et les évolutions autour des LoRA et des outils comme ComfyUI continuent de nourrir l’écosystème communautaire.
En résumé, Stable Diffusion incarne une avancée majeure dans l’IA générative: open source, flexible et capable, avec une communauté active et des possibilités d’intégration variées. Il se distingue par son accessibilité, ses possibilités de personnalisation et sa capacité à s’intégrer dans des workflows professionnels complexes, tout en offrant une alternative crédible et transparente face aux solutions propriétaires.