Cette article explore l’installation et l’optimisation de Stable Diffusion et des grands modèles de langage sur des GPU AMD via ROCm, principalement sous Fedora, avec des considérations pratiques pour Fedora 42 et ROCm 6.3. Il s’agit d’un récapitulatif basé sur le processus décrit dans le document source et destiné à aider les utilisateurs francophones à obtenir des performances satisfaisantes sur des cartes AMD comme la RX 6750 XT.
Contexte général
Stable Diffusion et les LLMs tournent de manière fluide sur plusieurs versions récentes, grâce à l’écosystème ROCm d’AMD et à des bibliothèques d’accélération adaptées. ROCm est la plateforme de calcul d’AMD nécessaire pour exploiter les GPU AMD dans les tâches d’IA générative. PyTorch est largement utilisé pour les projets Python, et l’intégration ROCm dans PyTorch doit être cohérente avec la distribution et les versions Python disponibles.
Le choix du système d’exploitation et de la distribution est crucial puisque Windows limite les versions ROCm et PyTorch, alors que Linux offre davantage d’options et de performances. Fedora est privilégié ici pour son ethos “bleeding-edge” et pour une intégration complète des paquets ROCm, ce qui facilite l’expérience expérimentale avec l’IA générative.
Pré-requis et architecture simplifiée
- ROCm: mise en place du stack de calcul AMD pour utiliser l’accélération GPU dans les projets IA.
- Compileur C++: nécessaire pour compiler les applications qui utilisent ROCm, notamment llama.cpp.
- Python: langage lisible et populaire; utilisé par Stable Diffusion WebUI Forge et d’autres projets IA.
- PyTorch: bibliothèque principale pour l’accélération GPU et la gestion des tenseurs.
Pour un déploiement sous Fedora avec ROCm 6.3, la version Python recommandée et les dépendances doivent être choisies avec soin afin d’assurer la compatibilité avec les bibliothèques et les modules Python utilisés par Stable Diffusion WebUI Forge et par llama.cpp.
Installation de ROCm sur Fedora 42
- Utiliser DNF pour installer les ensembles ROCm nécessaires et les outils associés. Exemple de commande: sudo dnf install
. - Il faut installer une large palette de paquets ROCm pour assurer la stabilité et les performances dans les projets lourds (llama.cpp, Stable Diffusion WebUI Forge, etc.).
- La distribution évolue: un métapaquet ROCm est en préparation pour simplifier l’installation future.
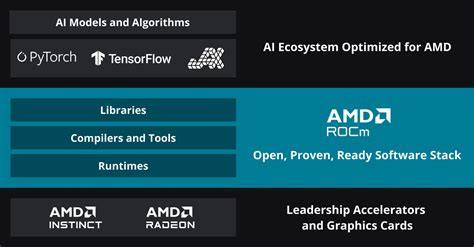
Le schéma ci-contre illustre les couches de la pile logicielle et le rôle de chaque élément dans l’orchestration du calcul sur GPU AMD.
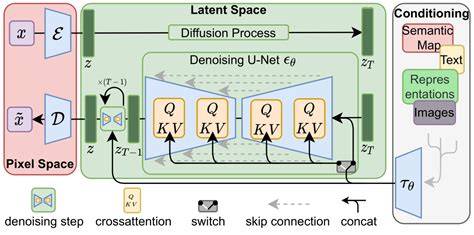
Stable Diffusion WebUI Forge avec ROCm sur Fedora 42
- Stable Diffusion WebUI (SDWebUI) Forge est courant comme fork privilégié en raison de son actualisation plus rapide et de sa compatibilité avec les modèles récents comme Flux.
- Python 3.12 est privilégié pour Fedora 42 et ROCm 6.3 afin de préserver la compatibilité avec les dépendances de Forge (par exemple sentencepiece).
- PyTorch 2.7.0+ROCm6.3 est recommandé; il nécessite Python 3.9 à 3.13, Fedora 42 livrant Python 3.13, ce qui peut composer parfaitement le tableau.
- SDWebUI Forge crée par défaut un environnement virtuel dans [installfolder]/venv/. Pour un déploiement global, on peut envisager une version plus ancienne de Stable Diffusion afin de centraliser les dépendances.
- Pour lancer Forge, on active l’environnement virtuel puis on exécute le script d’installation et on vérifie que la carte AMD est détectée (VRAM et version de PyTorch affichées).
Exemple d’étapes clés:
- python3.12 pour lancer l’environnement et compatibilité hardware.
- webui.sh pour installer et démarrer Forge après vérification de la détection de la carte AMD.
- Prévoir des ajustements si des dépendances comme insightface nécessitent une installation manuelle supplémentaire.
Performance WebUI et bibliothèques associées: AMD propose xformers et des versions personnalisées qui utilisent Composable Kernel; flash-attn peut fonctionner avec CK ou Triton. Pour les cartes Navi 31, PyTorch 2.5+ active l’option Flash Attention expérimentale via le drapeau TORCH_ROCM_AOTRITON_ENABLE_EXPERIMENTAL=1, à définir dans les variables d’environnement.
Optimisations et paramètres GPU pour Stable Diffusion
- Utiliser des arguments CLI adaptés dans webui-user.sh: --cuda-malloc et --cuda-stream pour l’optimisation mémoire et le parallélisme.
- Pour les modèles nécessitant un contrôle avancé, uploader des modèles GGUF depuis HuggingFace et configurer le serveur llama.cpp avec les bons paramètres (par exemple -ngl 999, -c 4096, --flash-attn).
- Vérifier que BLAS = 1 au démarrage de llama.cpp pour confirmer l’offload sur le GPU et que le modèle est chargé sur le GPU après le lancement.
Utiliser Mikupad pour les prédictions et la gestion des serveurs est décrit comme simple et efficace: il suffit de renseigner l’adresse du serveur et d’appuyer sur Predict.
llama.cpp et Mikupad avec ROCm sur Fedora
llama.cpp est l’engine d’inférence derrière LM Studio, Ollama et KoboldCpp. Pour RX 6750XT, la commande cmake est adaptée à gfx1031 et à l’emplacement de hipconfig -R pour trouver le bon hipcc. Pour d’autres GPU, des cibles gfx1030, gfx1100, gfx1200, etc., sont proposées selon les familles RX.
Après compilation, il faut récupérer des modèles GGUF ( DeepSeek V2 Lite est cité comme exemple >10b) et lancer llama-server avec les bons paramètres (-port 11434 -m DeepSeek-V2-Lite-Chat.Q4_K_M.gguf -c 4096 -ngl 999 --flash-attn).
Pour vérifier le bon fonctionnement: l’indication BLAS = 1 et le chargement du modèle sur le GPU permettent de confirmer que l’inférence s’effectue sur le GPU ROCm.
Utilisation de Mikupad et perspectives
Mikupad se contente d’un réglage des détails du serveur; il suffit d’indiquer l’adresse et de lancer Predict lorsque tout est prêt. L’essor des bibliothèques d’accélération expérimentales sur AMD (xformers, PyTorch, flash_attn) passe par le concept de composable kernel pour une meilleure compatibilité GPU large.
Architecture et performances: aperçu récapitulatif
Stable Diffusion et les LLM sous ROCm dépendent de la cohérence entre ROCm, PyTorch et les bibliothèques tierces. Les mises à jour ROCm qui se propagent vers les bases PyTorch et les packages de distribution peuvent prendre du temps et exiger des ajustements. Fedora est mis en avant comme une plateforme qui facilite ces mises à jour et le packaging ROCm intégré.
Les choix de versions Python et des environnements virtuels influencent la compatibilité des dépendances (sentencepiece, torch, etc.). Un équilibre est nécessaire entre les besoins logiciels et les capacités matérielles - notamment la VRAM disponible et les cibles GPU spécifiques telles que gfx1031 pour RX 6750XT.
Donnees et considérations pratiques
- ROCm 6.3 et PyTorch 2.7.0+ROCm6.3 exigent Python 3.9-3.13; Fedora 42 fournit Python 3.13, ce qui convient.
- SDWebUI Forge nécessite des versions compatibles de Python (3.12 ou 3.13 selon les dépendances) et peut nécessiter des ajustements pour des dépendances comme sentencepiece.
- Les commandes d’installation ROCm et les paquets associés varient selon les versions de Fedora et ROCm; vérifier les paquets disponibles et les métapaquets lorsqu’ils existent.
Conclusion intermédiaire
Cette approche pratique permet d’exécuter Stable Diffusion et des LLMs sur AMD ROCm sous Linux, en privilégiant Fedora pour sa souplesse et sa préparation ROCm. Le processus implique l’installation minutieuse de ROCm, du compilateur C++, de Python et de PyTorch compatibles, puis l’installation et le démarrage de SDWebUI Forge et llama.cpp avec les paramètres optimisés pour RX 6750XT ou d’autres GPU RDNA.
Ressources et accès rapide
- Documentation ROCm et compatibilités PyTorch pour ROCm 6.3 et PyTorch 2.7.0+ROCm6.3.
- Guides Fedora et Fedora 42 référençant les paquets ROCm et les outils de compilation.
- Guides sur Stable Diffusion WebUI Forge et llama.cpp pour les paramètres spécifiques de ROCm et GPU RDNA.