Le permis de conduire est un document complexe pour l’extraction automatisée: l’OCR (reconnaissance optique de caractères) et le NLP (traitement du langage naturel) jouent un rôle clé dans la détection des zones de texte et l’identification des champs essentiels tels que le nom, le prénom, le numéro du permis, la date de délivrance et les catégories autorisées. Cette approche permet une structuration automatique des données pour une intégration fluide dans les systèmes d’information.
La robustesse de l’extraction dépend de la qualité des images: que le permis soit scanné ou pris en photo avec un smartphone, les algorithmes doivent s’adapter. Des variantes comme l’ancien format rose en trois volets et le nouveau format carte exigent une détection automatique de la structure du document afin d’extraire les informations correctes sans perte de précision.
La solution s’appuie sur une API accessible avec une documentation complète, proposant des comptes démo et des démonstrations pour tester le flux d’extraction dans différents contextes métiers. Pour enrichir l’expérience, il est possible de commencer par une bibliothèque de modèles sectoriels et, si nécessaire, de créer des modèles personnalisés adaptés à des besoins spécifiques.
Fonctionnalités clés de l’OCR pour le permis de conduire
Extraction précise des champs essentiels tels que le numéro du permis, la date de délivrance et la date de validité, le nom et l’autorité de délivrance, quel que soit le format du document. L’OCR identifie les zones de texte et, via le NLP, comprend les relations entre les champs pour une structuration fiable des données.
La personnalisation est au cœur de la solution: les champs peuvent être entièrement personnalisables et les modèles existants constituent un point de départ pour ajouter ou modifier des champs, afin de répondre à des exigences spécifiques du secteur ou de l’organisation.
Intégration et déploiement
La solution est conçue pour s’intégrer facilement dans des environnements juridiques et de conformité grâce à une architecture centrée sur la protection des données et la conformité réglementaire, avec audits SOC 2 et conformité RGPD, HDS et HIPAA. L’utilisation peut se faire via une API avec une documentation complète, facilitant l’intégration dans les flux de travail existants.
Les plans proposés incluent différentes options, y compris des options entreprise adaptées à des volumes importants. Il est possible d’importer des fichiers PDF ainsi que tous les formats d’image courants comme PNG et JPEG, ce qui permet une grande flexibilité lors de l’ingestion de documents.
Cas d’usage et bénéfices
Pour les organisations, l’extraction automatisée du permis offre une réduction des délais de traitement, une diminution des erreurs manuelles et une meilleure traçabilité des informations sensibles. En pratique, les modèles couvrent divers secteurs d’activité, et les utilisateurs peuvent optimiser les flux pour répondre à des exigences spécifiques sans compromettre la sécurité des données.
Les champs généraux et les champs répétés constituent une structure claire lorsque le document contient des éléments récurrents, comme les descriptions ou les prix dans le cadre d’un relevé ou d’un devis lié au permis (par exemple dans les contextes d’assurance ou de vérification professionnelle).
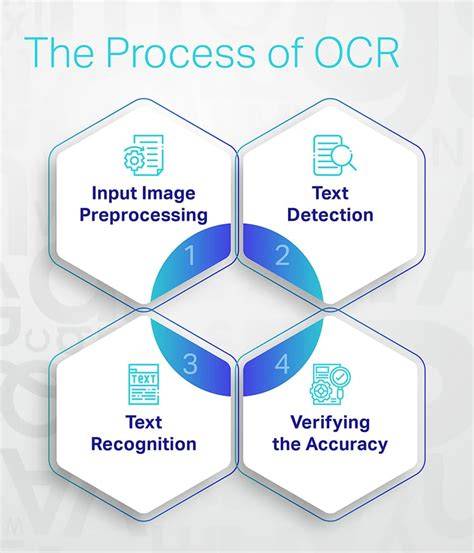
Infographie possible: protocole OCR et pipeline NLP pour le permis de conduire.
Vidéo potentielle montrant une démonstration d’extraction OCR sur différents formats de permis.
Tableau récapitulatif des champs et options
| Champ | Description | Personnalisation |
|---|---|---|
| Numéro du permis | Identifiant unique du document | Oui |
| Date de délivrance | Date d’émission | Oui |
| Date de validité | Date d’expiration | Oui |
| Nom | Nom du titulaire | Oui |
| Autorité de délivrance | Organe délivrant | Oui |
| Catégories | Catégories autorisées sur le permis | Oui |
Les modèles d’extraction offrent des champs généraux (informations apparaissant une seule fois dans le document) et des champs répétés (informations apparaissant plusieurs fois, comme les descriptions d’articles ou les lignes d’un devis). Cette distinction permet d’optimiser la structure des données et d’adapter l’extraction à des documents variés liés au permis et à la vérification d’identité.
En somme, l’OCR associée au NLP pour le permis de conduire permet une extraction fiable, une intégration aisée et une adaptabilité forte, tout en respectant les exigences de sécurité et de conformité des environnements sensibles.
tags: #permis #de #conduite #vectoriser