Le calcul haute performance est un domaine dynamique, Nvidia NVLink représentant l'une des avancées les plus importantes en matière d'évolutivité et de vitesse des GPU. Ici, nous expliquerons exactement ce qu'est Nvidia NVLink, y compris tout, de son architecture aux avantages et cas d'utilisation. Que vous soyez amateur de jeux ou ingénieur en IA, connaître cette technologie peut améliorer considérablement la puissance de votre système. Dans cet article, j'aborderai quelques aspects techniques, les comparerai aux interconnexions traditionnelles et donnerai des conseils sur la meilleure façon d'exploiter leur potentiel.
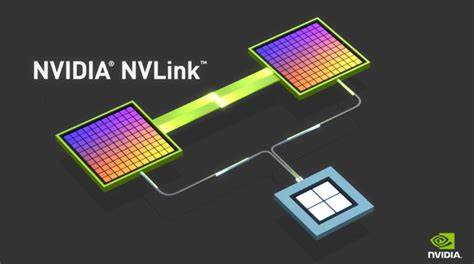
NVIDIA NVLink a été conçu pour que les GPU puissent communiquer facilement. Cela signifie que cela peut les aider à communiquer avec les processeurs, d’autres éléments de calcul haute performance ou entre eux. Les connexions PCIe traditionnelles sont souvent plus lentes que NVLink, qui a beaucoup plus de bande passante et une latence beaucoup plus faible, permettant à plusieurs GPU d'agir comme une seule grande équipe. Tout cela se traduit par un traitement synchronisé avec de meilleurs taux de transfert de données, ce qui est très utile lorsque l'on travaille sur l'apprentissage profond, l'analyse de données complexes ou les simulations scientifiques, entre autres applications gourmandes en données.
NVLink et PCIe : bande passante, latence et évolutivité
À l'ère de l'intelligence artificielle (IA), du calcul haute performance (HPC) et des applications gourmandes en données, NVIDIA NVLink révolutionne les interconnexions haut débit pour GPU et CPU. Protocole de communication à large bande passante et faible latence, NVLink permet un transfert de données fluide entre les processeurs, offrant des performances inégalées pour l'entraînement de l'IA, les simulations scientifiques et les charges de travail d'entreprise. Ce guide complet explique ce qu'est NVLink, son fonctionnement, ses avantages et ses applications, offrant aux professionnels de l'informatique et aux architectes de centres de données des informations pour optimiser leur infrastructure.
En ce qui concerne la bande passante, la latence et l'évolutivité, il existe des différences majeures entre NVLink et PCIe, le premier utilisant une nouvelle génération de puces NVSwitch. Chaque lien de NVLink fournit une bande passante de 300 Go/s, ce qui est nettement supérieur au maximum de 64 Go/s fourni par PCIe 4.0. Cet énorme gain de bande passante permet un transfert de données plus rapide entre les GPU, réduisant ainsi le temps de traitement des charges de travail gourmandes en données. De plus, par rapport au PCIe, NVLink a une latence plus faible, ce qui réduit le temps d'attente pour la communication entre les éléments connectés. Concernant l'évolutivité, NVLink gagne encore car sa conception permet à plusieurs cartes graphiques (GPU) de fonctionner comme un seul système avec une communication transparente entre elles. Ceci est très utile dans les applications informatiques à grande échelle où l’efficacité et la vitesse sont les plus importantes.
Au fil des années, NVLink a développé des interconnexions plus rapides et des calculs plus efficaces. Lors de son lancement en 2016, NVLink 1.0 offrait une bande passante de 80 Go/s, ce qui en a immédiatement fait la nouvelle norme en matière de communication GPU. NVLink 2.0 est sorti avec Volta en 2017 et a doublé la bande passante de l'itération précédente à 150 Go/s tout en ajoutant la prise en charge de la cohérence du cache, ce qui permet d'obtenir une meilleure efficacité d'utilisation de la mémoire. Accompagnant la sortie d'Ampère en 2020, NVLink 3.0 a encore augmenté ce chiffre en augmentant le taux de transfert théorique maximum jusqu'à environ six fois plus - avec désormais un taux de transfert potentiel maximal d'environ +400 % par rapport à son prédécesseur (NV Link4). Arrivant enfin dans l'architecture Hopper de Nvidia au cours de la ou des dernières années, cette version la plus récente offre plus de neuf cents Go/s par liaison tout en étant économe en énergie grâce à un ensemble de fonctionnalités de correction d'erreur améliorées, qui comprend également des mécanismes d'économie d'énergie améliorés.
Composants et architecture
La puce NvSwitch fait partie intégrante du réseau NVLink, améliorant l'évolutivité et les performances des clusters GPU. Le NvSwitch fonctionne comme une interconnexion rapide qui permet à de nombreux GPU de communiquer efficacement entre eux au sein d'un serveur ou sur plusieurs serveurs. Plusieurs connexions NVLink peuvent être prises en charge par chaque puce NvSwitch, permettant ainsi d'obtenir des bandes passantes élevées pour le transfert de données entre les liaisons GPU à faible latence. Ce type de puissance est nécessaire lorsqu'il s'agit de calculs lourds tels que la formation en IA, les simulations scientifiques ou l'analyse de données, qui nécessitent des paramètres multi-GPU où il ne devrait y avoir aucune interruption dans le flux de données et où toutes les ressources doivent être utilisées de manière optimale.
La quatrième génération de la technologie NVLink apporte des améliorations significatives dans la communication entre les unités de traitement graphique (GPU) en leur offrant une plus large gamme d'options d'interconnectivité, une bande passante plus rapide et une meilleure efficacité que leurs prédécesseurs. Ce dernier type peut atteindre jusqu'à 600 Go/s, ce qui représente une augmentation considérable en termes de taux de transfert de données, permettant ainsi aux applications nécessitant une puissance de calcul élevée de mieux fonctionner. Il prend également en charge plus de liens par GPU que toute autre version de NVLink antérieure, ce qui rend l'ensemble du réseau suffisamment robuste pour les configurations complexes impliquant plusieurs GPU évolutifs. Cela inclut, entre autres, des améliorations de correction d'erreurs qui garantissent l'intégrité ainsi que des mécanismes de tolérance aux pannes lors des transferts à grande vitesse, ce qui en fait la solution la plus adaptée aux environnements d'IA, d'apprentissage profond ou HPC où la fiabilité compte le plus.
L'intégration de NVLink dans les GPU NVIDIA A100 et H100 constitue un grand pas en avant vers l'interconnectivité et la puissance de calcul. Dans l'A100, NVLink fournit 600 Go/s par GPU de bande passante combinée, ce qui conduit à une communication ultra-rapide grâce à l'utilisation des liaisons NVLink requises pour les charges de travail d'IA et d'apprentissage en profondeur à grande échelle. De plus, les GPU H100 intègrent des connecteurs NVLink plus performants qui offrent des bandes passantes plus larges par connexion. Un autre avantage apporté par ces deux modèles est leur capacité à corriger les erreurs et à mieux tolérer les pannes qu'auparavant grâce aux puces et commutateurs NVSwitch impliqués dans l'obtention de vitesses de données plus élevées dans diverses parties d'un système informatique.
NVLink et applications
NVLink est une interconnexion propriétaire NVIDIA qui utilise un protocole de communication série haut débit pour connecter les GPU et les CPU. Elle fonctionne comme une liaison point à point, permettant un transfert direct de données entre les processeurs sans recourir à des bus système plus lents comme le PCIe. NVLink sert de liaison à haut débit entre les processeurs en permettant une communication directe entre les GPU avec des délais minimes. Les connexions PCIe traditionnelles créent principalement des goulots d'étranglement des données dans les applications qui nécessitent de grandes quantités d'informations ; c'est ce que NVLink résout grâce à ses bandes passantes beaucoup plus larges. Cette architecture permet un transfert facile des données entre différents GPU, leur permettant ainsi de partager des tâches plus efficacement via les liens fournis par NVLinks. Une caractéristique importante de ces liens est leur capacité à prendre en charge une mémoire cohérente sur de nombreuses cartes graphiques, en traitant ces mémoires comme s'il s'agissait d'un seul pool. De plus, la tolérance aux pannes et les capacités de correction d'erreurs intégrées à chaque aspect du fonctionnement aident à maintenir l'intégrité tout en transférant des données à des vitesses très élevées dans NVLink. Par conséquent, cette technologie devient nécessaire non seulement pour les supercalculateurs mais également pour les environnements informatiques d’entreprise où vitesse doit être combinée avec fiabilité sans aucun compromis dans un sens ou dans l’autre.
En comparant NVLink aux technologies d'interconnexion traditionnelles telles que PCIe, il existe plusieurs différences clés. L'un d'entre eux est qu'il dispose d'une bande passante beaucoup plus élevée - jusqu'à 25 Go/s par liaison, contrairement au maximum de 4.0 Go/s par voie du PCIe 16 dans une configuration à 16 voies. Enfin et surtout, parce que la fiabilité est plus importante que jamais, même dans ces environnements très performants où la précision doit être précise en raison de contraintes de temps, c'est‑à‑dire que des codes de correction d'erreur ont été créés. Par conséquent, ils peuvent détecter les erreurs pendant la transmission, en s’assurant qu’aucune erreur ne se produit sur aucun canal de communication, même si cela signifie ralentir tout le reste. Assurez-vous simplement que tout fonctionne bien ensemble pour toujours jusqu’à la fin des temps, amen !
Pour améliorer l'évolutivité et l'efficacité de NVLink, NVSwitch a été développé comme un commutateur entièrement connecté avec une bande passante élevée. Lorsque plusieurs GPU sont intégrés au système, ils peuvent communiquer directement via ce commutateur sans aucun problème, maximisant ainsi la puissance de calcul de chaque GPU. Selon la conception de NVSwitch, chaque GPU se connecte via plusieurs liens pour regrouper plus de bande passante, réduisant ainsi la latence. De plus, NVSwitch prend en charge des fonctionnalités avancées de partage de mémoire. Lorsqu'il traite des quantités massives d'informations à des vitesses ultra-rapides sur des réseaux étendus utilisés pour le calcul intensif, ce produit garantit que des mécanismes de tolérance aux pannes et de correction des erreurs sont en place sur l'ensemble du réseau afin qu'il n'y ait aucun fichier corrompu ou incomplet transféré pendant le processus de transfert, car il fonctionne à des hauteurs si élevées que même de petites erreurs peuvent entraîner des échecs catastrophiques.
NVLink est déployé dans des environnements hautes performances où la vitesse et l'évolutivité sont essentielles. Plus de bande passante : NVLink offre une bande passante bien supérieure à celle des connexions PCIe traditionnelles. Latence réduite : NVLink réduit considérablement la latence en permettant une communication directe entre les GPU. Architecture de mémoire unifiée : avec NVLink, l'espace d'adressage de mémoire unifié est pris en charge afin que différents GPU puissent partager la mémoire sans effort. NVLink améliore les charges de travail de calcul haute performance (HPC) en augmentant la vitesse de transfert de données et l'évolutivité. Dans les configurations HPC courantes, il peut y avoir un goulot d'étranglement dans l'efficacité des calculs en raison du transfert de données entre plusieurs GPU ou entre CPU et GPU. Relocalisation des données plus rapide : NVLink fournit des bandes passantes bidirectionnelles allant jusqu'à 300 Go/s, ce qui est beaucoup plus rapide que le meilleur débit PCIe possible. Ressources informatiques et mémoire unifiée : NVLink prend en charge une architecture de mémoire unifiée qui favorise un partage efficace de la mémoire entre différents processeurs graphiques.
Cas d'usage et besoins en distances
L'utilisation de NVLink dans les prévisions météorologiques est l'un des principaux domaines. La mise en œuvre de NVLink par le Centre national de recherche atmosphérique (NCAR) a été réalisée dans le but d'améliorer la vitesse et la précision de leurs modèles climatiques. L'adoption de NCAR sur les GPU compatibles NVLink a entraîné une augmentation significative de la vitesse de calcul, ce qui leur a permis de traiter des données atmosphériques complexes plus rapidement qu'auparavant. NVLink a joué un rôle essentiel dans la recherche génomique et dans l'accélération du séquençage et de l'analyse du génome. Des entreprises comme WuXi NextCODE ont intégré NVLinks dans leurs cadres HPC afin de garantir un traitement rapide des données génomiques et de gagner du temps sur cette tâche particulière. En utilisant NVLinks entre les GPU, les problèmes d’interconnectivité ont été résolus, ce qui a conduit à une analyse transparente sur de vastes ensembles de données génétiques.
Les applications de l'IA ou du ML ne seraient pas complètes sans mentionner dans quelle mesure ils ont adopté NVLinks. OpenAI, en tant que laboratoire de recherche de premier plan en IA, utilise cette technologie pour rendre la formation de grands réseaux neuronaux plus facile qu'auparavant. Il est nécessaire d'entraîner ces modèles plus rapidement, entre autres, car de nombreuses choses ne peuvent se produire que s'ils sont capables d'apprendre plus rapidement également, cela implique des ensembles de données qui peuvent nécessiter des vitesses plus élevées, nécessitant ainsi plusieurs liens au lieu de liens uniques. Ces exemples mettent en évidence les différentes manières dont le calcul haute performance peut bénéficier de l'utilisation de NVLink.
NVLink dans l’écosystème actuel et avenir
Le NVLink Spine est la dernière innovation réseau de NVIDIA, conçue pour interconnecter des milliers de GPU dans les plus grands data centers dédiés à l’intelligence artificielle. Issu du rachat de Mellanox, le NVLink Spine est un assemblage massif de plus de 5 000 câbles totalisant 3,2 km, orchestrant les échanges entre GPU, CPU, DPU et autres composants réseau. Chaque switch NVLink de cinquième génération dispose de 144 ports offrant une capacité de commutation non bloquante de 14,4 To/s. Formation et inférence IA : Les modèles géants, dépassant les billions de paramètres, nécessitent un débit et une synchronisation extrêmes. En offrant une bande passante locale supérieure à celle de l’Internet mondial, le NVLink Spine permet d’envisager des applications IA et scientifiques auparavant impossibles.
L'IA et le réseau chez NVIDIA expliqués : NVLink, InfiniBand, RDMA et Spectrum X | L'AVENIR DES R...
La sixième génération de NVLink dans NVIDIA Blackwell et les architectures associées promettent des performances d’inférence révolutionnaires et une meilleure efficacité énergétique. Le dialogue avec les acteurs du cloud (Microsoft, CoreWeave, Oracle Cloud) et les annonces orchestrées par NVIDIA montrent une trajectoire claire vers des déploiements à grande échelle, où les dense clusters multi-GPU et les interconnexions NVLink deviennent le socle de l’IA moderne. Cela inclut les solutions NVLink Fusion et les configurations avancées comme NVL72 et NVLink-C2C qui facilitent les échanges CPU-GPU et GPU-GPU sur des réseaux étendus.
Stable Diffusion reste un exemple emblématique de l’impact des interconnexions rapides sur l’entrainement et l’inférence des modèles génératifs. Si vous voulez former ou ajuster Stable Diffusion - que ce soit à partir de zéro, sur un jeu de données personnalisé, ou pour DreamBooth avec vos propres images - vous pourriez constater qu’un seul GPU ne suffit pas ou est trop lent. C’est ici que plusieurs GPUs entrent en jeu. L’entraînement de modèles de diffusion sur plusieurs GPUs dans le cloud peut accélérer considérablement le processus, mais introduit aussi de la complexité. Nous expliquerons ici les stratégies pour faire évoluer l’entraînement de Stable Diffusion sur GPUs, notamment sur une plateforme cloud comme Runpod.
Pourquoi escalader l’entraînement de Stable Diffusion sur plusieurs GPUs ? Stable Diffusion est un modèle volumineux, et l’entraînement implique d’énormes multiplications de matrices et beaucoup de données d’images. Les raisons d’utiliser plusieurs GPUs incluent la vitesse (2 GPUs peuvent idéalement traiter ~2× les données d’un GPU unique dans le même laps de temps), la mémoire (chaque GPU dispose de VRAM limitée et l’utilisation de plusieurs GPUs permet d’augmenter le pool mémoire effectif pour les lots), et les modèles plus gros comme SDXL qui nécessitent des ressources accrues.
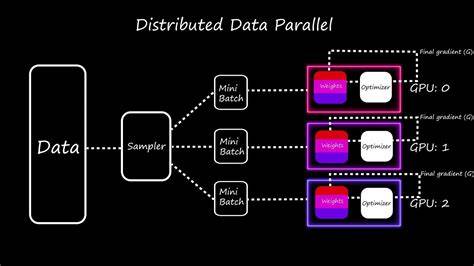
Les approches de formation multi-GPU couvrent Data Parallelism, Model Parallelism, Pipeline Parallelism et Hybrid Parallelism. En pratique, pour Stable Diffusion, le Data Parallelism est généralement privilégié: chaque GPU reçoit une copie du modèle et traite une portion du batch, les gradients étant synchronisés ensuite. Les cadres comme PyTorch DDP, PyTorch Lightning et Hugging Face Accelerate facilitent ces configurations. L’évolutivité est alors principalement limitée par la latence de synchronisation et le coût de communication entre GPUs. En moyenne, on observe un gain proche de linéarité jusqu’à ce que les frais de communication deviennent suffisants pour limiter l’accélération.
Exemple pratique: Fine-tuning de Stable Diffusion sur Runpod avec 2 GPUs. On lance une instance avec 2× NVIDIA 3090, on prépare le script de training (diffusers, kohya ss, etc.), on configure distributed training (accelerate config, puis accelerate launch train_text_to_image.py ...). Le batch est réparti entre les GPUs et chaque GPU est estimé à ~90% d’utilisation, mémoire environ 10 Go sur 24 Go par GPU. À la fin, les poids fine-tunés peuvent être obtenus plus rapidement qu’en single-GPU, puis l’instance est arrêtée pour arrêter la facturation.
Pour le cas du déploiement multi-nœuds (multi-machine), PyTorch distributed peut être utilisé avec --nnodes et des adresses maîtres, mais cela ajoute une complexité réseau et peut nécessiter des interconnexions rapides comme InfiniBand. Pour la plupart des utilisateurs, privilégier un seul nœud avec plusieurs GPUs est plus simple et efficace.
Bonnes pratiques et optimisations
Gestion des goulots d'étranglement: le chargement des données doit être suffisamment rapide pour alimenter tous les GPUs. Utiliser plusieurs workers et profils de cache peut aider. Synchronisation et mémoire: utiliser la précision mixte (FP16 ou BF16) permet d’économiser la mémoire et d’exploiter les tensor cores. Monitoring: surveiller l’utilisation des GPU et la VRAM, et veiller à ce que tous les GPUs soient équilibrés pour éviter que le ralentisseur ne bloque tout le processus. Des outils comme nvidia-smi en mode watch peuvent être utiles.
DeepSpeed et FSDP offrent des options avancées pour分e sous-traiter les poids et gérer les modèles extrêmement volumineux, mais pour Stable Diffusion en pratique, le DDP (Distributed Data Parallel) suffit souvent. L’expérience montre que même si l’évolutivité approche, les gains peuvent être inférieurs à 2× sur certaines configurations à cause des overheads, néanmoins l’efficacité globale demeure significative.